音声の超解像技術「Sidon」を使ってみた
この記事をよんで、「Sidon」というオープンソースの音声用超解像技術を知ったので使って見たいと思い、試してみました。
100年前の歌もAI超解像できる? 東京大学猿渡研「Sidon」で始めるAI歌声超解像(CloseBox)
試す過程でアプリも作ったので、実際に試したい人はダウンロードしてみてください。
(リンク)(約 3.79 GB)
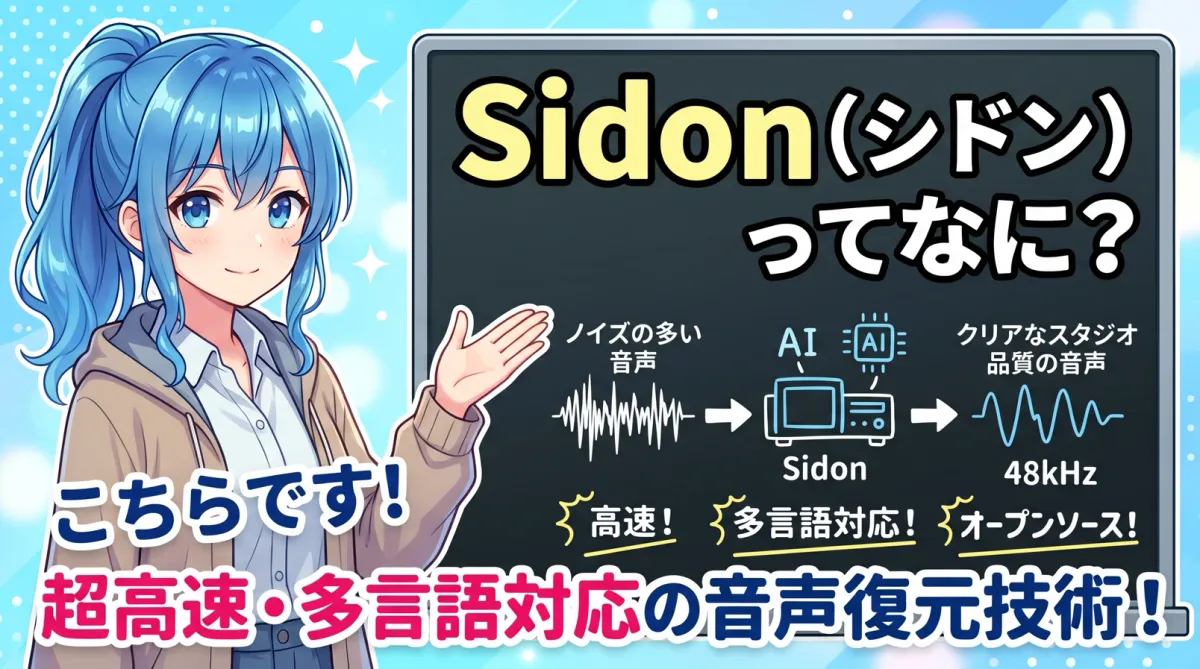
私の簡単な理解ですが、ノイズを取るみたいな単純な物では無く、いらない音は削除して、必要な音声の足りない部分をAIで生成して音を保管する技術です。
Sidon:大規模データセットのクレンジングのための、高速かつ堅牢なオープンソース多言語音声復元ツール
ここからはGemini先生に解説してもらいました。
Sidon(シドン)は、東京大学の研究チームが発表したオープンソースの多言語対応「音声復元(Speech Restoration)」モデルです。
周囲の雑音、部屋の反響(エコー)、音割れ、低音質化(電話音質など)といったノイズまみれの音声を、スタジオ録音並みのクリアな高音質(48kHz)に復元できます。
- なぜSidonが必要なのか?(開発の背景)
音声AIの「きれいな学習データ不足」問題
高品質な音声合成(TTS: Text-to-Speech)や音声AIを作るには、何万〜何百万時間もの膨大な音声データが必要です。しかし、ネット上や一般環境で収集した日常の音声(YouTubeや録音データなど)には、どうしても生活音・反響音・圧縮ノイズ・音割れが含まれてしまいます。
Googleの強力な技術(Miipher)が非公開だった
Googleは同様の目的で「Miipher」「Miipher-2」というデータ浄化(クレンジング)モデルを開発していましたが、モデルも学習コードも非公開(クローズド)でした。また、既存のオープンソース手法は英語専用だったり、性能が限定的でした。
そこで、「誰でも自由に使える、多言語対応・超高速なデータ浄化ツール」として開発されたのがSidonです。
- どうやって音声を復元しているのか?(仕組み)
Sidonは、音声を直接フィルタリングしてノイズを削るのではなく、「音の特徴を読み解いて、綺麗な音声として再合成する」という2段階のパイプラインを採用しています。
ノイズ混じりの音声
  └──> 【1. 特徴量予測器】(w2v-BERT 2.0 + LoRA)
         └─> ノイズを除去した「本来の音声特徴」を推定
  └──> 【2. ボコーダー】(HiFi-GAN + Snake activation)
         └─> 48kHzのスタジオ品質な波形を復元・生成
特徴量予測器(Feature Predictor)
143言語・450万時間で事前学習されたMetaの音声基盤モデル「w2v-BERT 2.0」を活用。
入力されたノイズ音声から、「雑音がなかった場合の理想的な音響特徴」を予測します。途中の第8層の特徴を抽出することで、話者独自の声色やイントネーションを損なわずに保持します。
ニューラルボコーダー(Vocoder)
予測された特徴量から、クリアな音声波形を復元します。
48kHzのフル解像度かつ高品質な波形を一気に生成します。
- Sidonの主な特徴と強み
| 特徴 | 詳細 |
|---|---|
| GoogleのMiipherに匹敵する品質 | 音質評価スコア(NISQA、DNSMOS)や話者の声の再現度において、GoogleのMiipherと同等以上の復元精度を達成。 |
| 単一GPUで500倍速の超高速処理 | リアルタイム比で最大500倍の速度で動作。何万時間もある大規模データセットを短時間・低コストで一括処理可能。 |
| 100以上の言語に対応 | 104言語・計2,219時間の高品質データで学習されており、英語だけでなく日本語を含む多様な言語で頑健に動作。 |
| 完全オープンソース | コード・モデルの重み・デモが一般公開されており、研究者や開発者が誰でも利用・追試可能。 |
- どのような用途で使われるのか?音声合成(TTS)学習コーパスのクリーニング論文内の実験でも、Sidonで雑音を除去・高音質化した音声データセットを用いてTTSモデルを学習させたところ、合成音声の品質が明確に向上することが実証されています。古い音声アーカイブ・インタビュー録音の修復電話録音、Web会議の音声、歴史的アーカイブなど、帯域が狭く雑音が多い音声をクリアな音声へアップスケーリング・補正する用途にも活用できます。
と言うわけで、実際にWindowsで簡単にインストールして試せるアプリを作成してみました。
以下のリンクからダウンロードできます
(約 3.79 GB)
この記事書いたの1ヶ月前で、アップするの忘れてました・・・